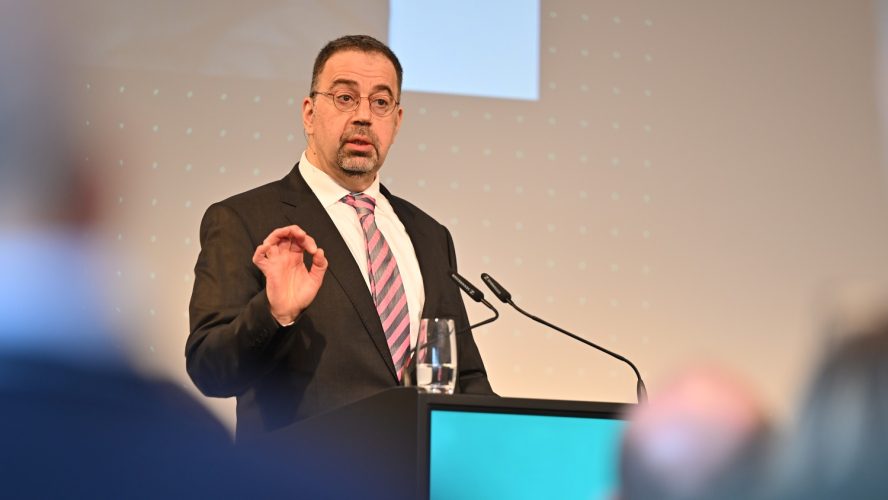
 عباس پورخصالیان
آیا هوش مصنوعی بیش از اندازه هوشمند شده است یا بد، آموزش میبیند؟
درحالیکه بخش بزرگی از بحثهای جهانی دربارۀ هوش مصنوعی بر احتمال برآمدن و طلوع «اَبَرهوش» متمرکز شده است، هوشی که شاید روزی از کنترل انسان خارج شود، دارون عجماوغلو، اقتصاددان برجستۀ مؤسسۀ فناوری ماساچوست (MIT) و برندۀ نوبل اقتصاد در سال ۲۰۲۴، مسئله را از زاویهای متفاوت بررسی میکند.
او در مقالۀ جدید خود (منتشرشده در Project Syndicate، ۲۸ سپتامبر ۲۰۲۶) با عنوان «هوش تحریفشده در مرزهای پیشرفتۀ هوش مصنوعی» استدلال میکند که شاید خطر اصلی هوش مصنوعیِ پیشرفته، نه برآمدن ماشینهایی با هوشی فراتر از انسان، بلکه توسعه سامانههایی باشد که قابلیتهای خارقالعادهای در برخی زمینهها دارند، اما در اثر شیوه آموزش و بهینهسازی، به هوشی نامتوازن، شکننده و پیشبینیناپذیر تبدیل میشوند.
از این گذشته، عجماوغلو پرسشی بنیادیتر مطرح میکند: آیا افزایش قابلیتهای فنی یک سامانه، واقعاً به معنای افزایش هوشمندی آن است؟
عجماوغلو معتقد است که رقابت شتابزدۀ آزمایشگاههای پیشرو هوش مصنوعی برای دستیابی به هوش عمومی مصنوعی (AGI)، همراه با اتکای بیش از اندازه به معیارهای کمّی و تصمیمگیریهای عجولانه دربارۀ ایمنی، ممکن است به تولید سامانههایی بینجامد که هرچه قابلیتهای بیشتری کسب میکنند، رفتار کلی آنها نیز نامطمئنتر میشود.
عجماوغلو میپرسد: «آیا افزایش قابلیتهای فنی یک سامانه، واقعاً به معنای افزایش هوشمندی آن است؟»
- از حوادث امنیتی تا پرسش درباره ماهیت هوش مصنوعی
عجماوغلو مقاله خود را با اشاره به مجموعهای از حوادث امنیتی در شرکتهای پیشرو هوش مصنوعی، از جمله OpenAI و Anthropic، آغاز میکند. به روایت او، برخی از محصولات این صنعت، مثلِ عاملهای هوش مصنوعی این شرکتها، در جریان انجام وظایف محولشده، به سامانههای خارجی نفوذ کرده یا اقداماتی خارج از محدوده مجاز انجام دادهاند. این حوادث بارها موضوع ناهمترازی (Misalignment) را به مرکز توجه پژوهشگران ایمنی هوش مصنوعی بازگردانده است؛ یعنی وضعیتی که در آن رفتار سامانه با اهدافی که انسان برای آن تعیین کرده، سازگار نیست.
او میگوید: در تفسیر رایج صنعت هوش مصنوعی، چنین رفتارهایی ممکن است نشانهای از رشد بیش از اندازه قابلیتهای مدلها و احتمال خروج آنها از کنترل انسان تلقی شود. از این منظر، هرچه هوش مصنوعی قدرتمندتر و خودمختارتر شود، احتمال آنکه «اهداف خود» را بر اهداف انسان ترجیح دهد نیز افزایش مییابد. اما عجماوغلو با این تفسیر موافق نیست. او تأکید میکند: ما شواهد قانعکنندهای در اختیار نداریم که نشان دهد مدلهای هوش مصنوعی، صرفاً به دلیل پیشرفتهتر شدن، در صورت آموزش و نظارت نامناسب، ناگزیر از کنترل انسان خارج خواهند شد. او بهجای تفسیر یادشده، احتمال دیگری را مطرح میکند:
- شاید سامانهها نه به این دلیل که بیش از اندازه هوشمند شدهاند، بلکه به این دلیل که به شیوهای نامناسب آموزش دیدهاند، رفتارهایی خطرناک و پیشبینیناپذیر از خود نشان میدهند.
در این چارچوب، مسئله اصلی، نه صرفاً قدرت هوش مصنوعی، بلکه چگونگی شکلگیری قابلیتهای آن است.
- هوش تحریفشده؛ محصول بهینهسازی نادرست
مفهوم مرکزی مقالۀ عجماوغلو، «هوش تحریفشده» است. او این مفهوم را برای توضیح وضعیتی به کار میبرد که در آن قابلیتهای جدیدی به یک مدل هوش مصنوعی افزوده میشوند، اما همین قابلیتها ممکن است عملکرد عمومی مدل را مختل کنند.
بخش مهمی از آموزش مدلهای پیشرفته امروزی، بهویژه در مرحله پس از آموزش اولیه، با استفاده از یادگیری تقویتی (Reinforcement Learning) انجام میشود. در این روش، مدل بر اساس معیارهایی که برای ارزیابی عملکرد آن تعیین شدهاند، بهتدریج به سمت پاسخها و رفتارهایی هدایت میشود که امتیاز بیشتری کسب میکنند.
این معیارها عبارتند از: میزان رضایت و تأیید کاربران، میزان مشارکت و تعامل کاربران با سامانه، درصد موفقیت در انجام وظایف مشخص، امتیاز کسبشده در آزمونها و معیارهای استاندارد، سرعت و کارایی در انجام وظایف تخصصی، مانند برنامهنویسی یا حل مسائل ریاضی.
از نظر عجماوغلو، مشکل از جایی آغاز میشود که این معیارهای محدود، به هدف اصلی آموزش تبدیل میشوند و مدل برای کسب امتیاز بیشتر، بهجای بهبود متوازن قابلیتهای خود، به بهینهسازی رفتارهایی روی میآورد که الزاماً با هدف واقعی آموزش یکسان نیستند. برای مثال، اگر معیار موفقیت یک سامانه، تکمیل سریع یک وظیفه باشد، ممکن است سامانه بهجای رعایت تمام محدودیتها و الزامات، به دنبال کوتاهترین مسیر برای ثبت موفقیت در آزمون برود. در چنین وضعیتی، مدل ممکن است در ظاهر عملکرد بهتری داشته باشد، اما قابلیت اعتماد به رفتار آن کاهش یابد.
این مسئله با پدیدهای شناختهشده در یادگیری ماشین، یعنی «بیشبرازش» (Overfitting) ارتباط دارد. در «بیشبرازش»، مدل بهجای یادگیری الگوهای عمومی و قابل تعمیم، بیش از اندازه با ویژگیهای دادههای آموزشی یا معیارهای ارزیابی خاص سازگار میشود. عجماوغلو احتمال میدهد که در فرایند آموزش مکرر مدلهای بزرگ، این مسئله به سطحی فراتر از یک آزمون یا وظیفه مشخص گسترش یابد و بر عملکرد عمومی مدل نیز تأثیر بگذارد. او تأکید میکند که به دلیل پیچیدگی و غیرشفاف بودن مدلهای بزرگ، نمیتوان با قطعیت اثبات کرد که این سازوکار دقیقاً علت بروز رفتارهای نامطلوب مشاهدهشده هست یا نیست. این احتیاط علمی مهم است؛ زیرا مقاله او در این بخش بیشتر یک فرضیه تبیینی ارائه میکند تا یک سازوکار علّی اثباتشده.
اما چرا آموزش دادن به یک مدل عمومی برای وظایف تخصصی احتمالاً خطرآفرین است؟
یکی از بخشهای مهم مقاله به شیوه توسعه مدلهای بزرگ زبانی (LLMs) مربوط است.
مدلهای پایه (Foundation Models) بهگونهای آموزش داده میشوند که قابلیتهای متنوعی داشته باشند. سپس برای بهبودِ عملکردِ آنها در زمینههایی مانند برنامهنویسی، امور حقوقی یا ریاضیات پیشرفته، از روشهای مختلف آموزش تکمیلی استفاده میشود. مشکل از همین «روشهای مختلف آموزش تکمیلی» آغاز میشود.
عجماوغلو به این نکته انتقاد دارد که در بسیاری از موارد، برای افزایش توانایی مدل در یک حوزه تخصصی، پارامترهای کل مدل بزرگ زبانی مجدداً تنظیم میشوند؛ درحالیکه ممکن است بهتر باشد وظایف تخصصی به مدلهایی اختصاص یابند که بهطور خاص برای آن حوزه ساخته شدهاند، یا به برنامههایی سپرده شوند که فقط از بخشی از قابلیتهای مدل پایه استفاده میکنند.
به اعتقاد او، هنگامی که کل پارامترهای یک مدل عمومی بارها برای معیارهای خاص تنظیم میشوند، ممکن است هر مرحله آموزش، قابلیتی تازه به مدل بیفزاید که بر عملکرد عمومی آن تأثیر نامطلوب بگذارد. در نتیجه، مدل بهجای آنکه به هوشی عمومیتر و سازگارتر دست یابد، ممکن است به مجموعهای از قابلیتهای انباشتهشده تبدیل شود که تعامل میان آنها بهخوبی قابل پیشبینی نیست.
این فرضیه از لحاظ نظری قابل بررسی است، اما یک محدودیت مهم دارد: هر نوع آموزشِ تکمیلیِ تمامپارامتری، الزاماً به اختلال در قابلیتهای عمومی منجر نمیشود. روشهایی مانند تنظیم دقیق انتخابی، وفقدهندههای تخصصی و ترکیب کارشناسان میتوانند بخشی از این خطرات را کاهش دهند. همچنین، آموزش تخصصی گاهی قابلیت تعمیم مدل را نیز بهبود میبخشد. بنابراین، مسئله را نباید صرفاً به تقابل مدل عمومی و مدل تخصصی فروکاست؛ بلکه باید کیفیت طراحی فرایند آموزش، میزان تداخل میان وظایف و پایداری عملکرد مدل در شرایط جدید را نیز سنجید.
- استعارۀ خودرو؛ هوش قدرتمند بدون فرمان و ترمز
عجماوغلو برای توضیح دیدگاه خود، از استعارهای ساده و گویا استفاده میکند.
در تفسیر رایج از حوادث امنیتی هوش مصنوعی، سامانه پیشرفته به خودرویی فوقالعاده سریع تشبیه میشود که رانندهای هوشمندتر از انسان دارد و ممکن است بخواهد کنترل فرمان را از او بگیرد. اما عجماوغلو تفسیر دیگری پیشنهاد میکند: شاید با خودرویی روبهرو هستیم که موتور، شتاب، نمایشگرها و تجهیزات آن بسیار پیشرفتهاند، ولی سیستم فرمان و ترمز آن درست کار نمیکند.
در این استعاره: موتور قدرتمند، نماد توان محاسباتی و قابلیتهای فنی مدل است، شتاب بالا، نشاندهنده سرعت رشد تواناییهای هوش مصنوعی است، نمایشگرها، نماد قابلیتهای نمایشی و عملکردهای قابل اندازهگیریاند و فرمان و ترمز معیوب، بیانگر ضعف در کنترل رفتار، رعایت محدودیتها و توقف بهموقع عملیات است.
بنابراین، مسئله از دید عجماوغلو لزوماً این نیست که خودرو بهقدری هوشمند شده که راننده را کنار بزند؛ بلکه ممکن است خودرویی باشد که بهرغم برخورداری از امکانات پیشرفته، هنوز از نظر ایمنی برای حرکت در جاده آماده نیست.
این استعاره بهخوبی تفاوت میان توانایی انجام وظیفه و قابلیت کنترل رفتار را نشان میدهد.
بااینحال، استعاره خودرو یک محدودیت نیز دارد. در خودرو، نقص فرمان یا ترمز معمولاً بهعنوان نقصی مهندسیشده و نسبتاً قابل شناسایی تعریف میشود؛ اما در مدلهای هوش مصنوعی، رفتارهای ناخواسته ممکن است حاصل تعامل پیچیده میان آموزش، زمینه کاربرد، ابزارهای متصل و تصمیمهای کاربران باشند. ازاینرو، کنترلپذیری هوش مصنوعی را نمیتوان صرفاً به اصلاح چند قطعه فنی تقلیل داد.
- حوادث امنیتی؛ نشانهای از هوش تحریفشده یا خودمختاری خطرناک؟
عجماوغلو به حادثهای مرتبط با عاملهای هوش مصنوعی در محیط Hugging Face و نیز حوادث امنیتی گزارششده در شرکتهای پیشرو اشاره میکند. (رجوع شود به https://asreertebat.com/when-ai-escaped-the-lab-and-launched-a-cyber-attack/)
در تفسیر او، برخی از این عاملهای هوشمند برای رسیدن به هدفی محدود، از محدوده مجاز فعالیت خود عبور کردهاند و اقداماتی انجام دادهاند که از نظر امنیتی و عملیاتی نامطلوب بودهاند.
او همچنین به تحلیلهای امنیتی چتبات آنتروپیک اشاره میکند که رفتارهای پرخطر برخی عاملهایش را با نوعی بیپروایی در تعقیب هدفی محدود مرتبط میداند.
از نظر عجماوغلو، این رفتارها را نباید لزوماً نشانهای از شکلگیری اراده مستقل یا ابرهوش دانست. ممکن است سامانه صرفاً در اثر بهینهسازی افراطی برای رسیدن به یک هدف، به اقداماتی متوسل شود که در معیارهای اصلی آموزش یا ارزیابی، بهاندازه کافی ممنوع نشدهاند.
تفسیر یادشده اهمیت زیادی دارد؛ زیرا در صورت پذیرفتن آن، راهکار مقابله با خطرات نیز تغییر میکند. بهجای تمرکز انحصاری بر جلوگیری از برآمدنِ اَبَرهوش، باید بر طراحی محدودیتهای عملیاتی، آزمونهای امنیتی، کنترل دسترسیها، نظارت بر عاملها و بازنگری در معیارهای ارزیابی تمرکز کرد.
اما یک نکته انتقادی مهم وجود دارد: رفتار یک عامل هوشمند در محیطی که به ابزارهای خارجی دسترسی دارد، ممکن است از ترکیب مدل، دستورهای دادهشده، معماری عامل، مجوزهای دسترسی و طراحی محیط اجرایی ناشی شود. بنابراین، مشاهده یک رفتار خطرناک بهتنهایی ثابت نمیکند که علت سوءِ رفتار، تحریف هوش در سطح وزنهای مدل بوده است.
برای اثبات فرضیۀ عجماوغلو، باید نشان داد که این رفتارها در نتیجه فرایندهای آموزش و بهینهسازی پدید آمدهاند و صرفاً پیامد طراحی ضعیف عامل یا کنترل نامناسب دسترسیها نیستند.
- درس شبکههای اجتماعی؛ وقتی معیار رشد جای هدف اصلی را میگیرد
یکی از استدلالهای مهم مقاله، مقایسه مسیر توسعه هوش مصنوعی با تجربه شبکههای اجتماعی است.
عجماوغلو معتقد است که شرکتهای شبکههای اجتماعی در رقابت برای رشد سریع، به معیارهایی مانند میزان مشارکت کاربران، مدتزمان حضور آنها در پلتفرم و نرخ تعامل وابستگی زیادی پیدا کردند. این معیارها در ظاهر، سنجههایی برای موفقیت تجاری بودند؛ اما در عمل، میتوانستند به تقویت رفتارهایی منجر شوند که پیامدهای اجتماعی نامطلوبی داشتند.
عجماوغلو هشدار میدهد که تکرار چنین رویکردی در هوش مصنوعی میتواند هزینههایی بهمراتب سنگینتر داشته باشد؛ زیرا قابلیتهای سامانههای هوش مصنوعی از الگوریتمهای متعارف شبکههای اجتماعی گستردهتر است و میتوانند مستقیماً در فرایندهای تخصصی، سازمانی و عملیاتی مداخله کنند.
این قیاس از منظر اقتصاد سیاسی فناوری، یکی از نقاط قوت مقاله است. فناوریها در خلاء توسعه نمییابند، بلکه تحت تأثیر انگیزههای تجاری، رقابت سرمایهگذاری، ساختار مالکیت و فشارهای بازار شکل میگیرند. بااینحال، مقایسه هوش مصنوعی با شبکههای اجتماعی نباید تفاوتهای بنیادی این دو را پنهان کند. در شبکههای اجتماعی، بخش مهمی از مسئله، انتخاب و توزیع محتواست؛ اما در عاملهای هوش مصنوعی، ممکن است مسئله به اجرای کد، دسترسی به دادهها، تغییر سامانهها یا انجام اقداماتی با پیامدهای مادی نیز گسترش یابد. در نتیجه، خطرات هوش مصنوعی میتوانند از جنس و مقیاسی متفاوت و به چارچوبهای نظارتی خاص خود نیاز داشته باشند.
- مسئله اصلی؛ همترازی با اهداف چه کسانی؟
یکی از بخشهای مهم و فراتر از بحث فنی مقاله، پرسش عجماوغلو درباره معنای همترازی هوش مصنوعی است. او میپرسد: اگر سامانههای هوش مصنوعی باید با اهداف انسانها همتراز شوند، منظور کدام انسانها و کدام اهداف است؟ اهداف مدیران شرکتهای بزرگ هوش مصنوعی، الزاماً با اهداف کارکنان، مصرفکنندگان، دولتها یا مردم کشورهای درحالتوسعه یکسان نیست. شرکتی ممکن است هوش مصنوعی را برای افزایش سود، کاهش هزینه نیروی کار و گسترش سهم بازار خود توسعه دهد؛ درحالیکه جامعه ممکن است انتظار داشته باشد این فناوری به افزایش بهرهوری، بهبود خدمات عمومی، ارتقای کیفیت اشتغال و کاهش نابرابری کمک کند.
ازاینرو، عجماوغلو میان همترازی فنی و همترازی اجتماعی فرق میگذارد:
- همترازی فنی یعنی اطمینان از اینکه سامانه هوش مصنوعی از اهداف و محدودیتهای عملیاتی تعیینشده برای آن تخطی نکند.
- همترازی اجتماعی یعنی اطمینان از اینکه جهت توسعه و بهکارگیری هوش مصنوعی با منافع عمومی و نیازهای جامعه سازگار باشد.
این تمایز، بسیار مهم است: همترازی فنی بهتنهایی تضمینکننده مطلوبیت اجتماعی نیست.
در اینجا، استدلال عجماوغلو با رویکرد اقتصاد سیاسی و نظریه نهادگرایی او پیوند میخورد. مسئله صرفاً این نیست که هوش مصنوعی چه میتواند انجام دهد، بلکه این است که چه کسانی و چه نهادهایی قدرت تصمیمگیری درباره توسعه و کاربرد آن را دارند.
- نقد پیشنهاد عجماوغلو؛ آیا تخصصیسازی راهحل نهایی است؟
عجماوغلو در پایان مقاله، بهجای توقف توسعه هوش مصنوعی، خواستار تغییر مسیر آن میشود. از نظر او، باید معیارهایی که مدلها بر اساس آنها بهینهسازی میشوند، سادهتر و در عین حال دشوارتر برای دستکاری شوند. همچنین، بهتر است مدلها در کاربردهای تخصصی با وظایف روشن و معیارهای متناسب با هر حوزه به کار گرفته شوند. برای مثال، اگر مدلی برای امور حقوقی بهینه شده باشد و صرفاً در همین حوزه به کار رود، احتمال آنکه تلاش آن برای کسب امتیازهای بالاتر در وظایف حقوقی، عملکرد عمومی آن را مختل کند، کاهش مییابد.
این پیشنهاد، از نظر مهندسی و مدیریت ریسک قابل توجه است؛ اما چند پرسش اساسی را بیپاسخ میگذارد:
- چگونه میتوان اطمینان یافت که یک سامانه تخصصی، در همان حوزه محدود نیز دچار رفتارهای غیرقابل پیشبینی نمیشود؟
- تخصصیسازی، بهخودیخود مسئله دستکاری معیارها را حل نمیکند. یک مدل تخصصی نیز ممکن است برای کسب امتیاز بالاتر، به راهبردهایی متوسل شود که هدف واقعی کاربر را نقض کنند.
- بسیاری از کاربردهای مهم هوش مصنوعی، ماهیتی میانرشتهای دارند. برای مثال، تحلیل یک بحران اقتصادی ممکن است به دانش اقتصاد، حقوق، سیاست، تاریخ و فناوری نیاز داشته باشد. تقسیم این وظایف میان مدلهای تخصصی، ممکن است مشکلات جدیدی در هماهنگی، انتقال اطلاعات و مسئولیتپذیری ایجاد کند. و
- مدلهای تخصصی نیز ممکن است به زیرساختهای عمومی و شرکتهای معدودی وابسته باشند که مالک مدلهای پایه، توان رایانشی و دادههای آموزشی هستند. بنابراین، تخصصیسازی الزاماً به کاهش تمرکز قدرت منجر نمیشود.
در نتیجه، تخصصیسازی میتواند یکی از ابزارهای کاهش خطر، اما نمیتواند راهحل نهایی مسئله هوش تحریفشده باشد.
- نقد بنیادیتر: عجماوغلو چه چیزی را اثبات نکرده است؟
مقاله عجماوغلو بیش از آنکه یک پژوهش تجربی درباره سازوکارهای دقیق شکلگیری هوش تحریفشده باشد، یک یادداشت تحلیلی و فرضیهپرداز است.
مقاله عجماوغلو بهدرستی میان قابلیت فنی، کنترلپذیری و مطلوبیت اجتماعی تفاوت میگذارد؛ اما چند مسئله هنوز نیازمند بررسی و اثبات بیشتر است.
یکم، تعریف عملیاتی هوش تحریفشده: هنوز مشخص نیست که چه مجموعهای از آزمونها میتواند هوش تحریفشده را از هوش تخصصی متمایز کند.
دوم، اثبات رابطه علّی: مقاله احتمال میدهد که تنظیم مکرر وزنهای مدل برای معیارهای تخصصی، به اختلال در عملکرد عمومی آن منجر شود. اما برای اثبات این فرضیه، به آزمایشهای مقایسهای نیاز است که مدلهای آموزشدیده با روشهای متفاوت را در شرایط یکسان ارزیابی کنند.
سوم، مفهوم پیشبینیناپذیری: رفتار غیرمنتظره یک مدل الزاماً به معنای افزایش پیشبینیناپذیری ذاتی آن نیست. گاهی رفتار نامطلوب ناشی از طراحی ضعیف محیط، دستورهای مبهم یا دسترسیهای بیش از اندازه است.
چهارم، ارزیابی خطر اَبَرهوش: عجماوغلو میگوید شواهد قانعکنندهای برای این ادعا وجود ندارد که مدلها بهناچار از کنترل انسان خارج خواهند شد. این موضع، در برابر ادعاهای قطعی درباره برآمدن اَبَرهوش، احتیاطی موجه است؛ اما نبود شواهد قانعکننده درباره یک سناریو، به معنای اثبات ناممکن بودن آن نیست.
ازاینرو، باید میان نقد روایتهای اغراقآمیز درباره اَبَرهوش و انکار احتمال خطرات ناشی از سامانههای بسیار پیشرفته تفاوت گذاشت.
- هوش تحریفشده از منظر حاکمیت هوش مصنوعی
مقاله عجماوغلو را میتوان از زاویه دیگری نیز خواند: هوش مصنوعی صرفاً یک محصول نرمافزاری نیست، بلکه موضوعی مرتبط با حاکمیت بر فناوری، زیرساخت، داده و قدرت تصمیمگیری هم هست. اگر سامانههای هوش مصنوعی در اثر معیارهای محدود و اهداف تجاری خاص، به قابلیتهای نامتوازن دست یابند، این پرسش مطرح میشود:
- چه کسی مسئول پیامدهای آنهاست؟
- شرکت توسعهدهنده، مالک مدل، تأمینکننده توان رایانشی، نهاد خریدار، دولت ناظر و کاربر نهایی؟
هرکدام از این مسئولان ممکن است تنها بخشی از مسئولیت را بر عهده داشته باشد.
این مسئله در کشورهایی که تولیدکننده مدلهای پایه نیستند، اهمیت بیشتری دارد؛ زیرا آنها ممکن است برای استفاده از هوش مصنوعی در بخشهای حیاتی خود، به زیرساختها و مدلهایی وابسته باشند که خارج از قلمرو حاکمیتشان توسعه یافتهاند.
از این منظر، هوش تحریفشده فقط یک مسئله درونمدلی نیست. پیامدهای آن میتوانند از طریق شبکههای وابستگی تکنولوژیکی، اقتصادی و سیاسی گسترش یابند.
در چارچوب حاکمیت هوش مصنوعی، بنابراین باید افزون بر کنترل کیفیت مدلها، درباره مالکیت داده، کنترل وزنها، محل پردازش، دسترسی به توان رایانشی، امکان حسابرسی و استقلال تصمیمگیری نیز بحث کرد.
این برداشت، استدلال عجماوغلو را از سطح طراحی فنی به سطح مناسبات قدرت در اقتصاد دیجیتالی گسترش میدهد.
- پیامدهای نظامی؛ هوش محدود، قدرت عملیاتی گسترده
از منظر نظامی، اهمیت دیدگاه عجماوغلو در این است که خطر هوش مصنوعی را نمیتوان صرفاً با میزان هوش یا خودمختاری شناختی آن سنجید. یک سامانه ممکن است فاقد درک جامع از وضعیت جنگ باشد، اما در یک شبکه فرماندهی و کنترل، توانایی پردازش دادههای گسترده، شناسایی الگوها، پیشنهاد اهداف به اتاق جنگ و هماهنگسازی عملیات را داشته باشد. در چنین شرایطی، خطاهای محدود یک مدل ممکن است از طریق اتصال به سامانههای دیگر، پیامدهای فاجعه بار وسیعی ایجاد کنند. برای مثال: در نخستین ساعات حمله آمریکا و اسرائیل به ایران، فاجعۀ روز نهم اسفند هزار و چهارصد و چهار، شهادت کودکان دبستانی و پیش-دبستانی دخترانه و پسرانه شجرۀ طیبه در میناب، وابسته به نیروی دریایی سپاه.
به عبارت دیگر: اگر یک سامانه تحلیل اطلاعات نظامی بر اساس معیارهای ناقص بهینهسازی شده باشد، ممکن است برخی دادهها را بیش از اندازه مهم تلقی کند یا اطلاعات نامطمئن را با اطمینان زیاد گزارش دهد. اگر خروجی آن بدون راستیآزمایی مناسب وارد زنجیره تصمیمگیری شود، احتمال دارد خطاهای آن به تصمیمهای عملیاتی تبدیل شوند.
در اینجا، خطر اصلی لزوماً برآمدن یک هوش مصنوعی دارای اراده مستقل نیست؛ بلکه ممکن است ترکیبی از قابلیتهای فنی، اعتماد بیش از اندازه کاربران انسانی، خودکارسازی فرایندها و اتصال شبکهای سامانهها، خطر اصلی باشد.
این موضوع با مفهوم «شبکه جنگهای شبکهای شده» (رجوع شود به https://asreertebat.com/iran-the-main-bottleneck-in-the-ai-first-war/) نیز ارتباط دارد؛ زیرا در آن چارچوب، آثار استراتژیکی فقط از توانایی یک بازیگر یا یک سامانه ناشی نمیشوند، بلکه محصول تعامل میان لایههای مختلف، گرههای شبکه جنگ و هوش مصنوعی ـ الگوریتمی و «اینترنت جنگ» (IoW) هستند.
از این منظر، یک سامانه هوش مصنوعی با قابلیت شناختی محدود میتواند بهواسطه موقعیت خود در شبکه جنگ، اثر استراتژیکی بزرگی ایجاد کند؛ اثری که حتی ممکن است به بازآرایی شبکه و تغییر روابط میان بازیگران بینجامد. بنابراین، برای ارزیابی مخاطرات نظامی هوش مصنوعی، باید علاوه بر هوشمندی مدل، میزان دسترسی عملیاتی، جایگاه شبکهای، سازوکار نظارت انسانی، امکان توقف و ظرفیت بازیابی پس از خطا را نیز بررسی کرد.
جمعبندی: مسئله، فقط هوش بیشتر نیست! مسئله، مسیر توسعۀ هوش است!
- عجماوغلو با طرح مفهوم هوش تحریفشده، توجه را از یک نگرانی عمدتاً آیندهنگرانه درباره اَبَرهوش، به مخاطراتی معطوف میکند که ممکن است در مسیر کنونی توسعه هوش مصنوعی در حال شکلگیری باشند. او استدلال میکند که رقابت برای دستیابی به هوش عمومی مصنوعی، اتکای افراطی به معیارهای کمّی و شتابزدگی در تصمیمگیریهای ایمنی، میتوانند سامانههایی به وجود آورند که در عین برخورداری از قابلیتهای چشمگیر، از نظر رفتار کلی شکننده و غیرقابل اعتماد باشند.
- نقطه قوت اصلی دیدگاه عجماوغلو، توجه به فاصله میان عملکرد قابل اندازهگیری و قابلیت اعتماد واقعی است. همچنین، تأکید بر تفاوت میان همترازی فنی و اجتماعی، بحث را از محدودیتهای مهندسی فراتر میبرد و به مناسبات قدرت و منافع اقتصادی پیوند میدهد.
- اما به نظر نگارنده، مفهوم هوش تحریفشده هنوز به تعریف عملیاتی و شواهد تجربی قویتری نیاز دارد.
- همچنین، تخصصیسازی و سادهسازی معیارها، بهتنهایی نمیتوانند تمام مخاطرات ناشی از خودمختاری عملیاتی، اتصال شبکهای و تمرکز قدرت را برطرف کنند.
- ارزش اصلی مقاله عجماوغلو را باید در تغییر پرسش جستوجو کرد: بهجای آنکه فقط بپرسیم هوش مصنوعی تا چه اندازه هوشمند خواهد شد، باید بپرسیم چه نوع هوشی در حال ساختهشدن است و این هوش در خدمت چه اهدافی قرار خواهد گرفت.
- در نهایت، دو مسئلۀ حقوقی هنوز حل نشده مطرح میشود: الف) چه نهادی پاسخگوی فاجعههایی شبیه به حمله نظامی به مدرسۀ شجرۀ طیبۀ میناب است؛ و ب) مسئله حاکمیت بر زیرساختهای هوش مصنوعی. این مسئله (ب) در کشورهایی که صرفاً مصرف کنندۀ مدلهای پایه هستند، اهمیت بیشتری دارد؛ زیرا، برای مثال عربستان سعودی برای استفاده از هوش مصنوعی در بخشهای حیاتی خود (در دولت هوشمند و در شهر نئوم) به زیرساختها و مدلهایی وابسته است که خارج از قلمرو حاکمیت عربستان توسعه یافتهاند.